큰 모델과 큰 계산은 다르다
혼합 전문가 모델(Mixture of Experts·MoE)이 모든 파라미터를 매번 쓰지 않는 이유는 입력에 맞는 일부 전문가만 골라 계산하도록 설계됐기 때문이다. 모델 안에 많은 전문가를 담아 전체 파라미터 수는 키우되, 한 토큰을 처리할 때는 선택된 경로만 활성화한다. 이를 희소 활성화라고 부른다.
따라서 ‘전체 파라미터가 크다’와 ‘입력 하나를 처리할 때 계산하는 파라미터가 많다’는 같은 말이 아니다. MoE를 이해할 때 가장 먼저 분리해야 할 것도 전체 파라미터와 활성 파라미터다. 전자는 모델이 보유한 학습 용량에 가깝고, 후자는 특정 입력을 처리하면서 실제 연산에 참여하는 범위를 뜻한다.
이 구분은 AI 모델 출시 자료를 읽을 때 특히 중요하다. 거대한 파라미터 수만 보고 밀집 모델보다 무조건 느리다고 결론 내릴 수도 없고, 반대로 희소 모델이라는 이유만으로 더 빠르다고 단정할 수도 없다. 구조가 허용하는 계산 절감과 실제 시스템에서 측정되는 속도는 별개의 판단 대상이다.
밀집 모델과 MoE의 차이
일반적인 밀집 모델은 입력이 달라져도 해당 계층에 배치된 같은 파라미터 집합을 사용한다. 모든 토큰이 동일한 피드포워드 네트워크를 통과하는 식이다. 모델 규모가 커지면 이 경로의 계산량과 메모리 부담도 함께 커지기 쉽다.
MoE는 하나의 피드포워드 네트워크 대신 여러 전문가를 둘 수 있다. 여기서 전문가는 사람처럼 특정 분야를 명시적으로 담당한다는 뜻이라기보다, 학습 과정에서 서로 다른 파라미터를 갖게 된 계산 모듈을 가리킨다. 입력마다 모든 전문가의 답을 계산해 합치는 것이 아니라 라우터가 사용할 전문가를 먼저 정한다.
이 구조의 핵심은 선택 가능한 파라미터의 폭과 한 번에 실행하는 계산의 폭을 분리하는 데 있다. 전체 모델에는 다양한 전문가가 존재하지만 한 토큰은 그중 일부에만 전달된다. 모델 용량을 늘릴 때 매번 모든 전문가를 통과해야 하는 부담을 피하려는 설계다.
라우터가 토큰의 경로를 정한다
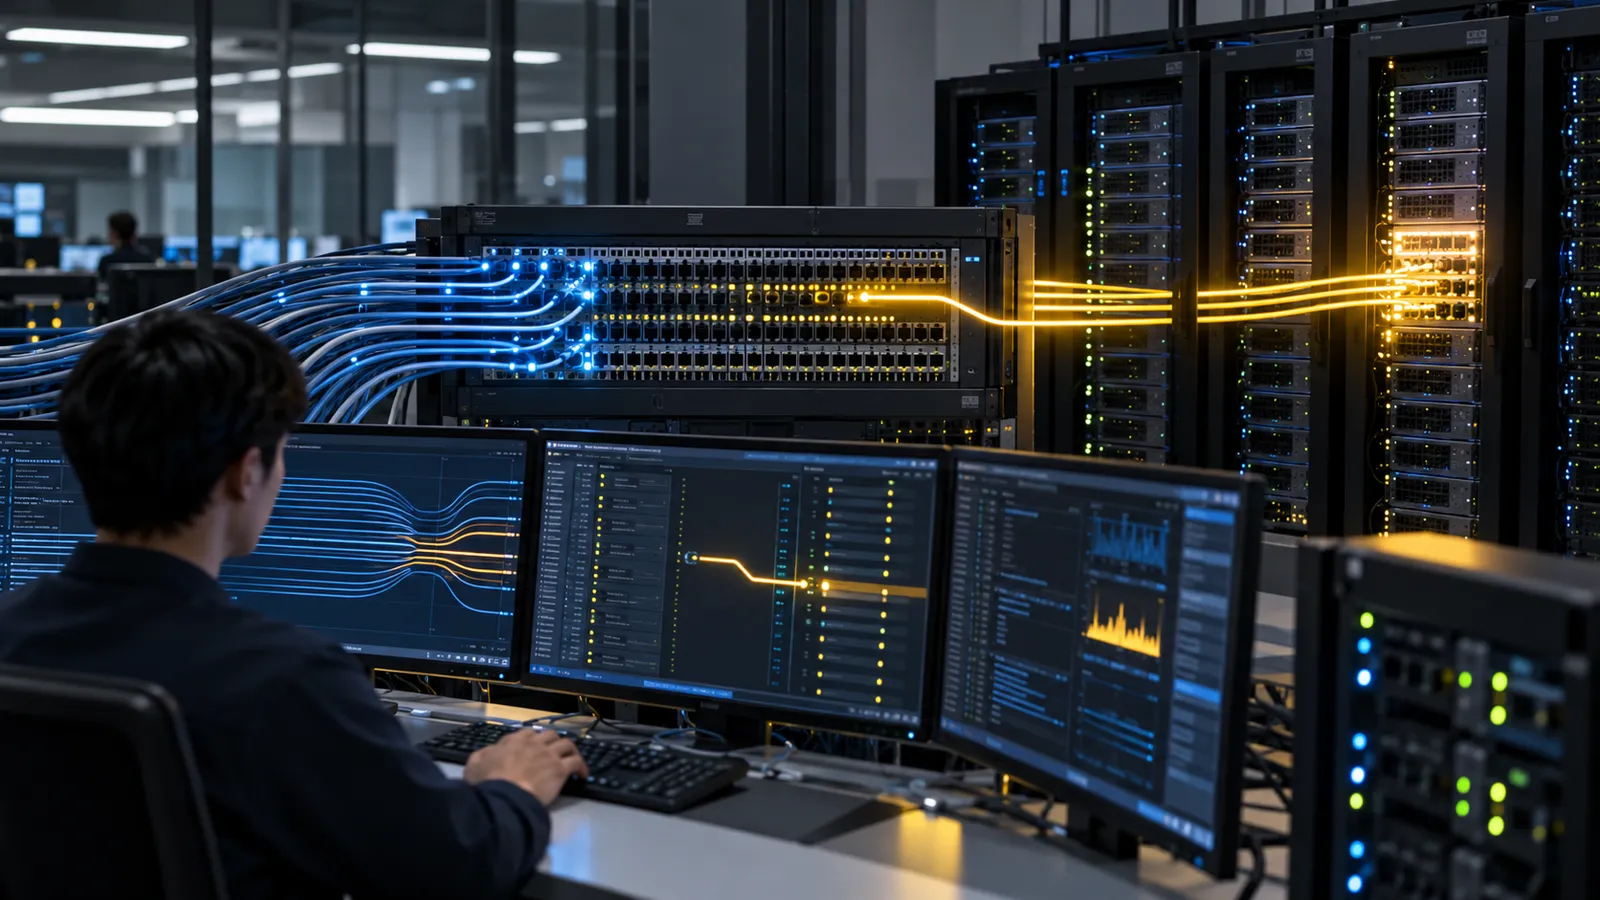
Switch Transformer에서는 Transformer 블록의 피드포워드 네트워크, 즉 FFN 부분을 여러 전문가로 바꾼다. 라우터는 각 토큰의 표현을 받아 전문가별 선택 확률을 계산하고, 가장 높은 확률을 받은 전문가 하나로 토큰을 보낸다. 선택된 FFN만 실행되므로 이를 top-1 라우팅이라고 한다.
처리 순서는 단순하다. 먼저 토큰이 라우터에 들어가고, 라우터가 전문가별 점수를 만든다. 이어 가장 높은 점수의 전문가가 그 토큰을 계산한다. 다른 전문가의 파라미터는 모델 안에 존재하지만 그 토큰을 처리하는 연산에는 참여하지 않는다. 같은 문장 안에서도 토큰별 라우팅 결과가 달라질 수 있다.
다만 top-1은 Switch Transformer가 채택한 구체적인 방식이지 모든 MoE 모델에 공통으로 고정된 규칙은 아니다. 다른 설계는 복수의 전문가를 선택하거나 라우팅과 출력을 결합하는 방법을 달리할 수 있다. MoE라는 이름만 보고 항상 전문가 하나만 활성화된다고 이해하면 안 된다.
파라미터 수를 읽는 기준
MoE의 전체 파라미터 수에는 매 입력에서 쉬고 있는 전문가의 파라미터도 포함된다. 예를 들어 여러 FFN 전문가 가운데 하나만 선택되는 구조라면, 발표된 전체 규모와 토큰당 활성 규모 사이에는 상당한 차이가 생길 수 있다. 그래서 밀집 모델과 MoE를 전체 파라미터 수 하나로 나란히 놓고 계산 비용을 비교하는 방식은 불완전하다.
살펴봐야 할 수치는 최소한 세 갈래다. 모델이 보유한 전체 파라미터, 토큰마다 활성화되는 파라미터, 그리고 실제 작업에서 측정한 처리량과 지연시간이다. 여기에 어떤 정밀도와 하드웨어를 썼는지, 전문가가 여러 장치에 분산됐는지도 결과를 바꾼다. 총규모는 모델의 저장·배치 부담과 관련되고, 활성 규모는 입력당 연산을 이해하는 단서가 되지만 어느 하나가 실제 비용 전체를 대신하지는 않는다.
결국 ‘더 큰데 계산은 비슷하다’는 설명은 동일한 조건에서 선택되는 전문가 수와 FFN 연산을 비교할 때 의미가 있다. 모델 전체를 메모리에 올리고 장치 사이에서 데이터를 이동하는 비용까지 사라진다는 뜻은 아니다.
희소 활성화의 현실적 비용
선택적 활성화는 계산을 줄일 가능성을 만들지만 속도 향상을 자동으로 보장하지 않는다. 전문가가 여러 가속기에 흩어져 있으면 토큰을 적절한 장치로 보내고 결과를 다시 모으는 통신이 필요하다. 특정 전문가에 토큰이 몰리면 장치별 작업량이 불균형해지고, 일부 장치가 끝날 때까지 다른 장치가 기다릴 수도 있다. 라우팅과 분산 실행이 추가하는 복잡성도 무시할 수 없다.
학습 안정성 역시 별도 문제다. Switch Transformer 논문은 통신 비용, 구현 복잡성, 학습 불안정성을 MoE 확산의 장애 요인으로 짚고 이를 완화하는 설계를 제시했다. 논문에서 보고한 사전학습 속도 향상도 T5·mT5 계열, 사용한 데이터와 계산 자원, 해당 실험 설정에서 나온 결과다. 이를 모든 MoE의 추론 속도나 어떤 하드웨어에서도 재현되는 배수로 확대할 수는 없다.
새 모델의 효율 주장을 볼 때는 전체 파라미터보다 먼저 토큰당 몇 개의 전문가가 활성화되는지 확인해야 한다. 그다음 실제 서비스와 가까운 조건의 지연시간·처리량, 사용 장치 수, 메모리 요구량을 함께 봐야 한다. MoE의 장점은 모든 파라미터를 항상 계산하지 않는 구조적 선택에 있다. 그 선택이 실제 이득으로 이어지는지는 라우팅, 부하 분산, 통신, 하드웨어 구성이 결정한다.
참고자료
참고 1: Journal of Machine Learning Research · Switch Transformers: Scaling to Trillion Parameter Models with Simple and Efficient Sparsity https://www.jmlr.org/papers/volume23/21-0998/21-0998.pdf 참고 2: labml.ai · Switch Transformer 구현 해설 https://nn.labml.ai/transformers/switch/index.html