보안이 우선입니다.
정밀도를 낮추는 진짜 목적
NVFP4가 AI 추론에서 정밀도를 낮추는 이유는 계산을 대충 하기 위해서가 아니다. 한정된 GPU 메모리와 메모리 대역폭, 연산 자원으로 더 많은 데이터를 처리하기 위해서다. 숫자 하나를 표현하는 비트 수가 줄면 모델의 가중치와 연산 중간값을 옮기고 보관하는 부담도 작아진다. 저정밀 연산을 직접 지원하는 하드웨어에서는 같은 시간에 더 많은 값을 처리할 여지도 생긴다.
다만 비트 수를 줄였다는 사실만으로 실제 추론이 무조건 빨라지는 것은 아니다. 수치 변환 비용, 지원되는 연산, 모델 구조와 배치 크기 등 전체 실행 조건이 함께 작용한다. NVFP4의 의미는 단순한 압축률보다 4비트 형식을 Blackwell의 Tensor Core 및 Transformer Engine과 연결하고, 낮은 정밀도에서 생길 수 있는 오차를 세분화된 스케일링으로 관리하는 데 있다.
E2M1이 줄이는 정보
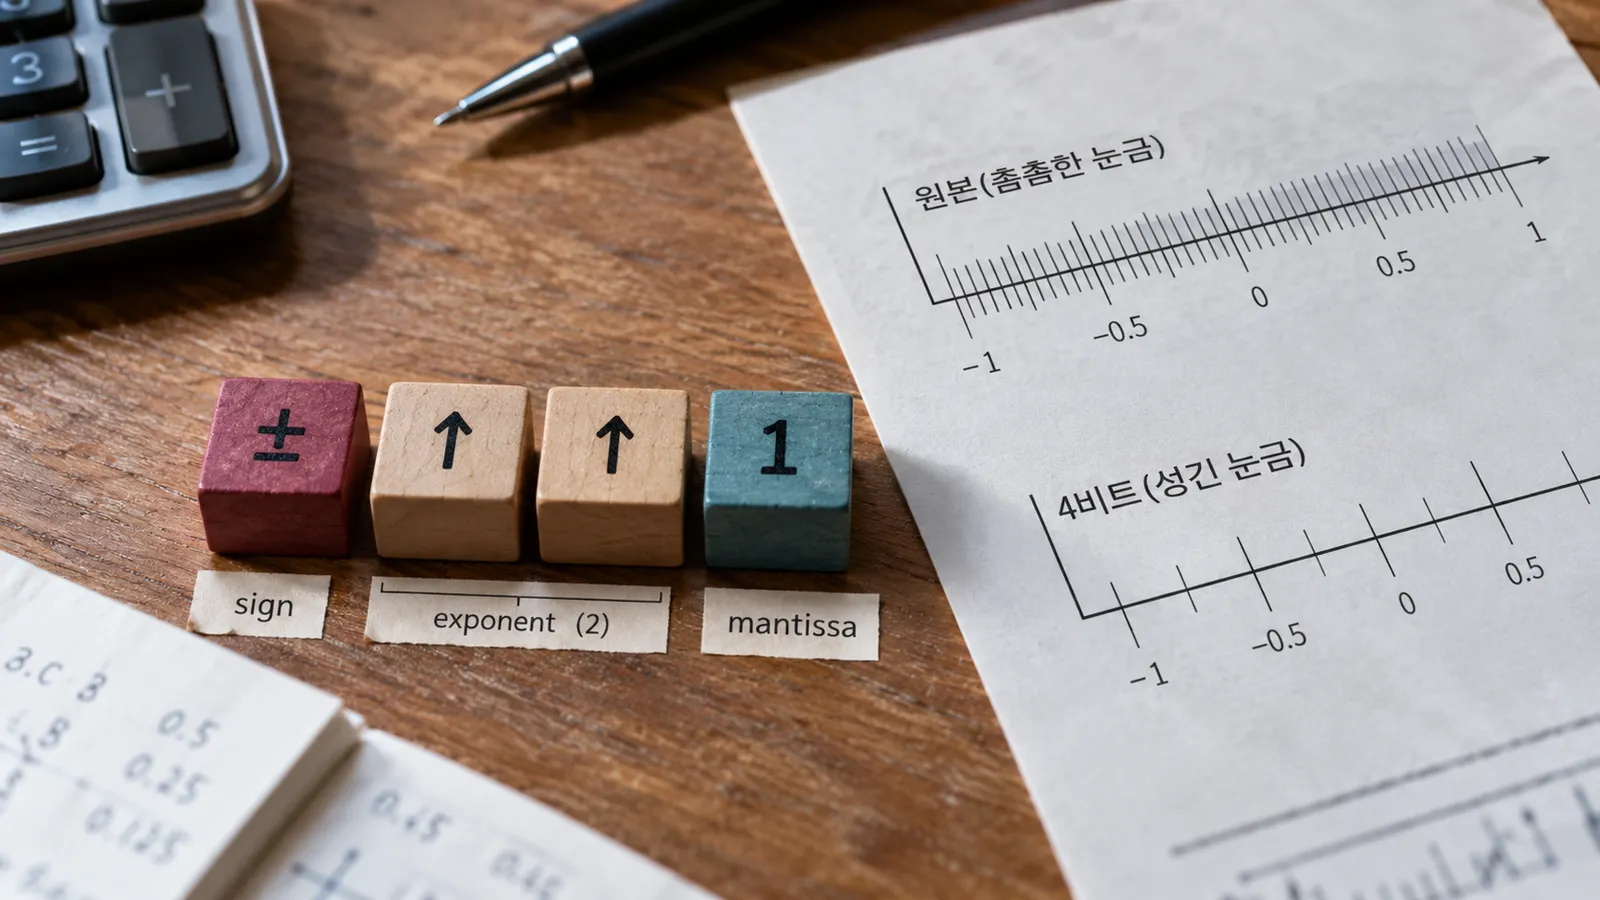
NVFP4에서 개별 값은 E2M1이라는 4비트 부동소수점 형식으로 저장된다. 부호에 1비트, 지수에 2비트, 가수에 1비트를 사용한다. 부호는 양수와 음수를 구분하고, 지수는 값의 대략적인 크기 범위를 정하며, 가수는 그 범위 안에서 값을 얼마나 세밀하게 표현할지를 담당한다.
4비트의 장점과 위험은 같은 지점에서 나온다. 표현에 필요한 데이터 양이 줄어드는 대신 나타낼 수 있는 수의 범위가 좁아지고 간격도 촘촘하지 않다. 원래 값이 표현 가능한 두 숫자 사이에 놓이면 가까운 값으로 바뀌어야 하고, 크기가 크게 다른 값들을 동일한 기준으로 변환하면 작은 값의 정보가 사라지거나 큰 값이 표현 범위를 벗어날 수 있다. 이런 오차가 연산을 거치며 누적되면 모델 출력 품질이 달라질 가능성이 있다. 따라서 4비트라는 숫자만 보고 효율과 정확도를 동시에 얻었다고 결론 내릴 수는 없다.
두 단계 스케일링의 역할
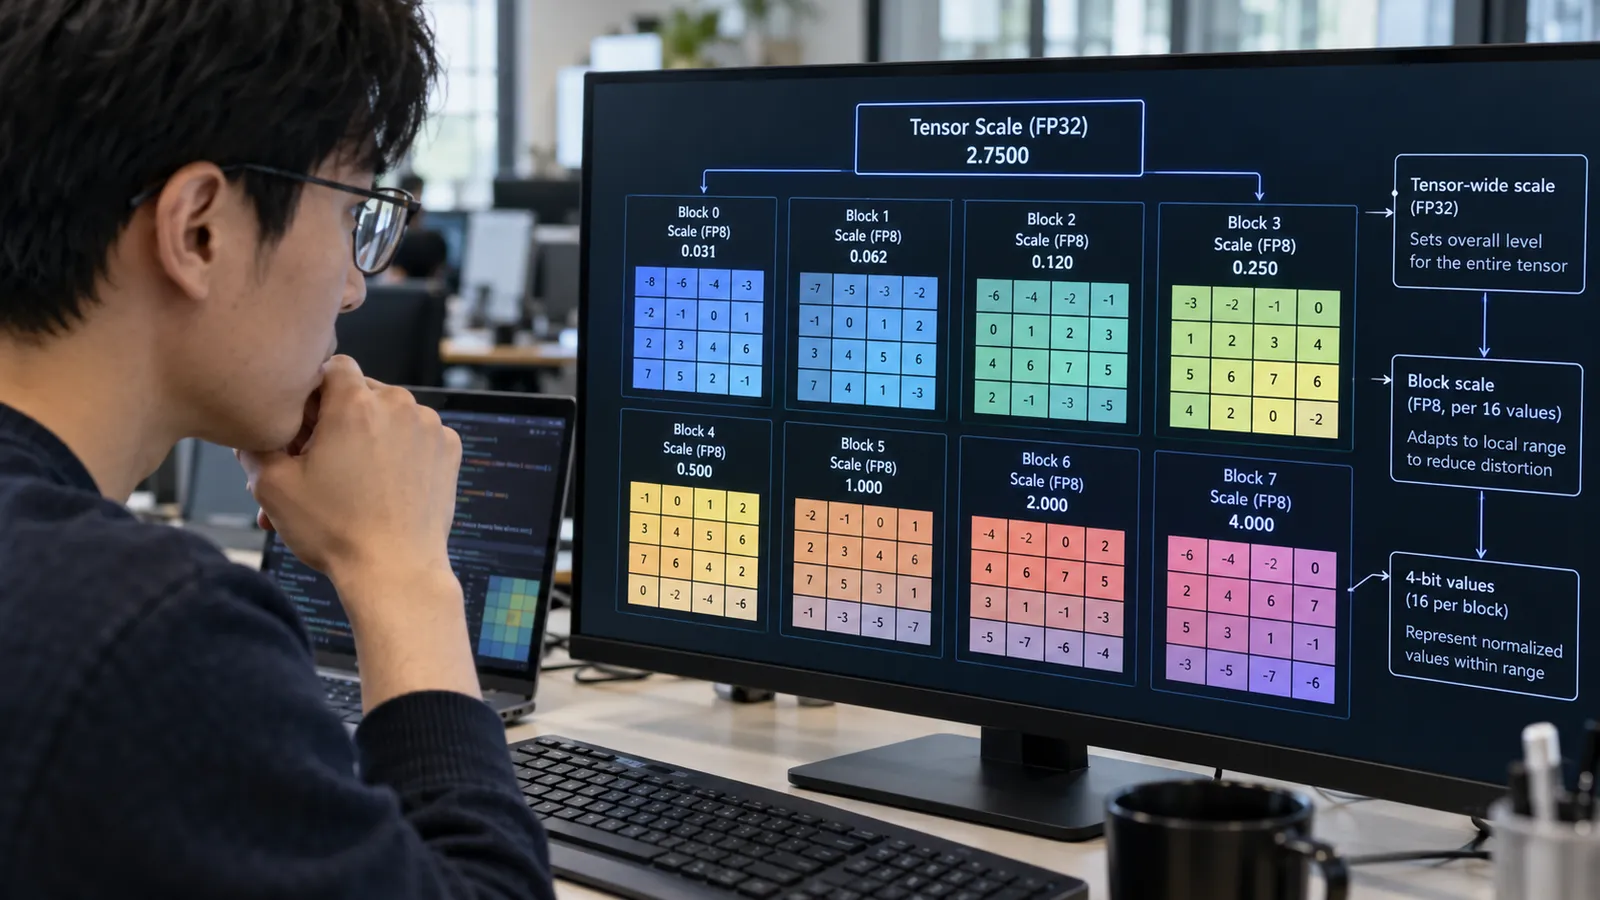
NVFP4는 좁은 표현 범위를 보완하기 위해 블록과 텐서라는 두 수준의 스케일을 사용한다. 먼저 연속된 16개 값이 하나의 작은 블록을 이루고 FP8 E4M3 스케일을 공유한다. 이 스케일은 블록 안의 실제 값들을 E2M1이 다룰 수 있는 범위에 맞추는 확대·축소 기준으로 이해할 수 있다.
블록을 작게 나누는 이유는 서로 크기가 비슷한 값끼리 더 알맞은 기준을 적용하기 위해서다. 텐서 전체에 하나의 기준만 적용하면 일부 큰 값이 범위를 결정해 작은 값들의 구분이 거칠어질 수 있다. 16개 값마다 기준을 두면 한 블록의 극단적인 크기 차이가 다른 블록에 미치는 영향을 줄일 수 있다. 이것이 마이크로 블록 스케일링이 정확도 손실을 완화하는 핵심 원리다.
여기에 텐서 전체를 대상으로 FP32 스케일이 한 번 더 적용된다. 블록별 FP8 스케일이 국소적인 값의 분포를 맞춘다면, 텐서별 FP32 스케일은 전체 크기 수준을 조정하는 상위 기준이다. 개별 값은 여전히 4비트로 저장되지만 두 층의 스케일이 실제 값의 크기를 복원하는 데 관여한다. NVFP4는 모든 정보를 4비트 안에 억지로 넣는 방식이 아니라, 작은 값 표현과 별도의 스케일 정보를 결합한 형식인 셈이다.
Blackwell 하드웨어와의 연결
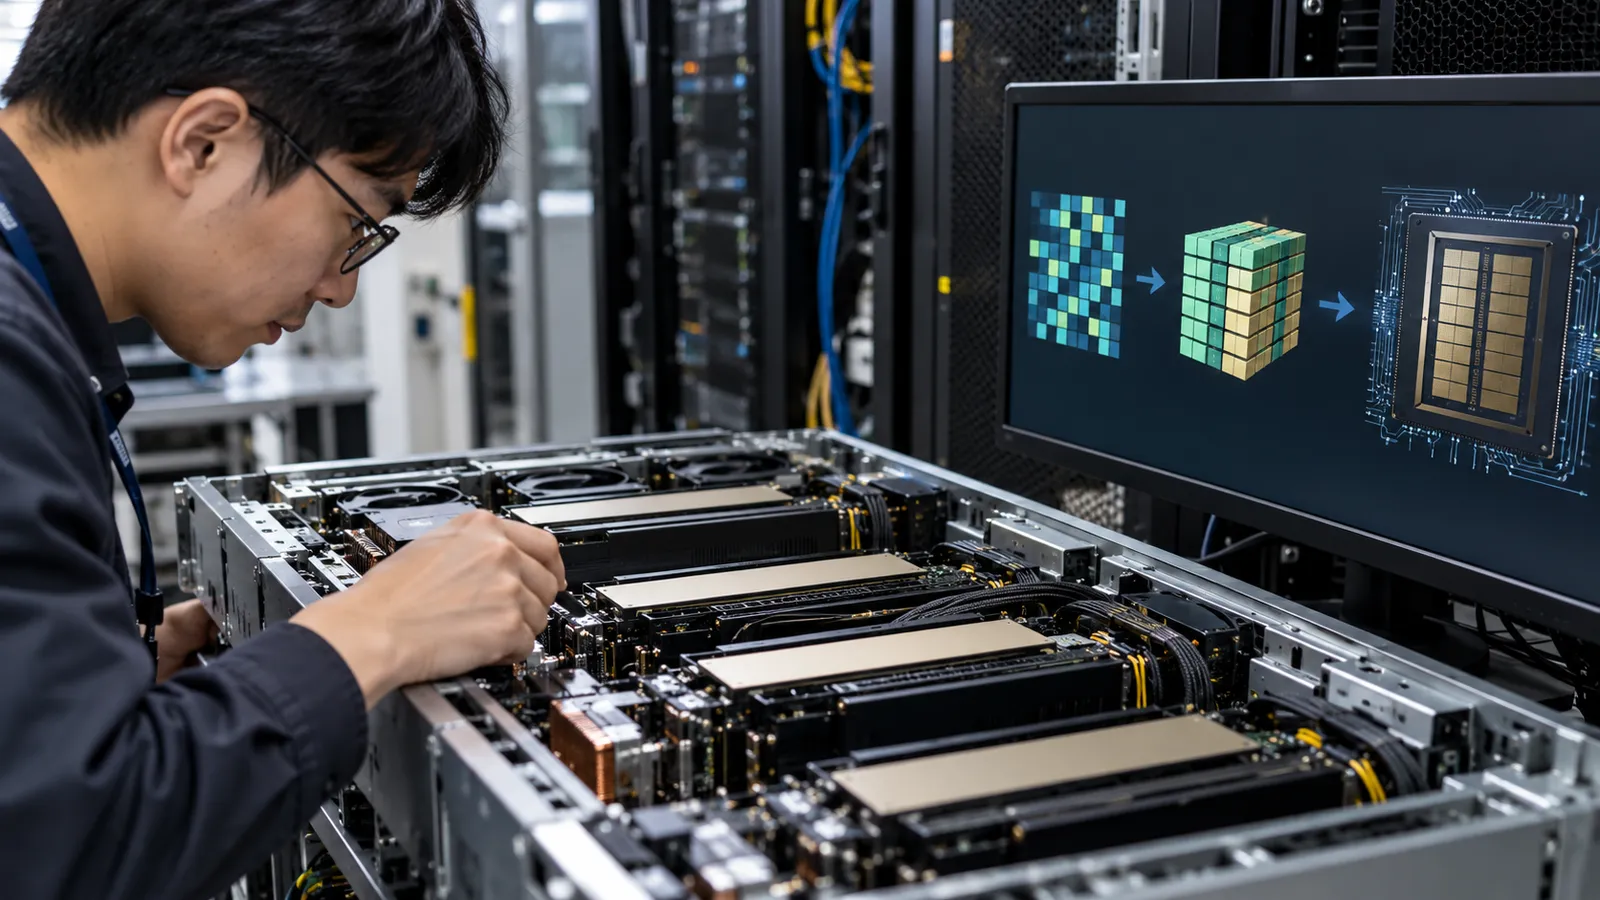
데이터 형식은 하드웨어가 직접 처리할 때 실용성이 커진다. NVIDIA는 Blackwell Tensor Core가 FP4를 지원하고, Transformer Engine이 마이크로 텐서 스케일링을 이용해 성능과 정확도의 균형을 조정한다고 설명한다. 즉 NVFP4의 4비트 값과 스케일 구조가 단순한 저장 규칙에 머물지 않고 실제 행렬 연산 경로와 연결된다.
NVIDIA는 이 구조가 더 높은 성능과 메모리에 수용할 수 있는 모델 크기 확대에 기여한다고 제시한다. 다만 이는 제조사가 Blackwell 아키텍처의 설계 효과를 설명한 수치다. 특정 모델이 같은 배수로 빨라지거나 같은 품질을 유지한다는 보편적인 보증으로 읽어서는 안 된다. 하드웨어가 FP4를 지원한다는 사실과 실제 서비스의 처리량 향상은 구분해야 한다.
성능 수치를 읽는 기준
NVFP4 결과를 볼 때는 처리량과 정확도를 함께 봐야 한다. 처리량만 높고 출력 품질이 크게 변한다면 적용 목적에 맞지 않을 수 있고, 정확도 변화가 작더라도 변환 과정이나 다른 병목 때문에 전체 서비스 속도가 기대만큼 개선되지 않을 수 있다.
Nota AI는 RTX PRO 6000에서 수행한 자체 측정에서 A100 대비 LLM 추론 처리량이 최대 두 배에 이르렀고 정확도 하락은 통계적으로 무시할 수준이었다고 보고했다. 이 결과는 NVFP4가 실제 시스템에서 활용될 가능성을 보여주는 사례지만, 제공된 자료만으로 대상 모델, 평가 데이터와 전체 정확도 지표까지 확인되지는 않는다. ‘최대’ 수치는 해당 측정 조건의 상단 결과이므로 모든 모델과 시스템에 그대로 적용할 수 없다.
실제 도입 판단에서는 비교한 GPU와 소프트웨어 경로가 무엇인지, 같은 모델과 입력 조건을 사용했는지, 처리량과 지연시간 중 어떤 지표를 측정했는지 살펴야 한다. 정확도 역시 평균값 하나보다 서비스에 중요한 작업에서 허용 범위를 벗어나는 변화가 없는지가 중요하다. NVFP4의 핵심은 정밀도를 무조건 희생하는 데 있지 않다. 4비트 표현으로 자원 부담을 낮추되, 블록별 FP8 스케일과 텐서별 FP32 스케일로 손실을 관리하는 것이다. 따라서 도입 여부는 ‘FP4인가’가 아니라 해당 모델과 하드웨어에서 효율 향상과 품질 변화가 함께 검증됐는지를 기준으로 결정해야 한다.
참고자료
참고 1: NVIDIA · NVIDIA Blackwell Architecture https://www.nvidia.com/en-in/data-center/technologies/blackwell-architecture/